
KOICA 코트디부아르 홍보영상 제작기 - 추가 촬영 없이 AI 영상 생성·AI 나레이션으로
추가 촬영은 없었습니다. 이번 프로젝트는 KOICA 코트디부아르 사무소의 2026년 하반기 홍보영상입니다. 주제는 '코트디부아르에 스며든 변화의 온기'. 보건과 교육을 중심으로 KOICA가 현지에서 이어 온 사업 여섯 건을 5분 남짓한 영상 한 편에 담는 작업이었습니다.
조건이 꽤 까다로웠습니다. 새로 찍지 않고 기관이 가진 사업 영상을 최대한 쓸 것, 코트디부아르와 아비장의 풍경은 따로 구할 것. 그런데 받은 소스는 사업마다 화질이 제각각이었고, 인터뷰는 전부 불어였습니다. 저희는 불어를 못 합니다.
이 글은 그 조건을 AI 영상 생성, AI 나레이션, 음성 인식 전사로 하나씩 풀어 간 기록입니다. 최종본은 5분 32초, 국문판과 불문판 두 가지로 나갔습니다.
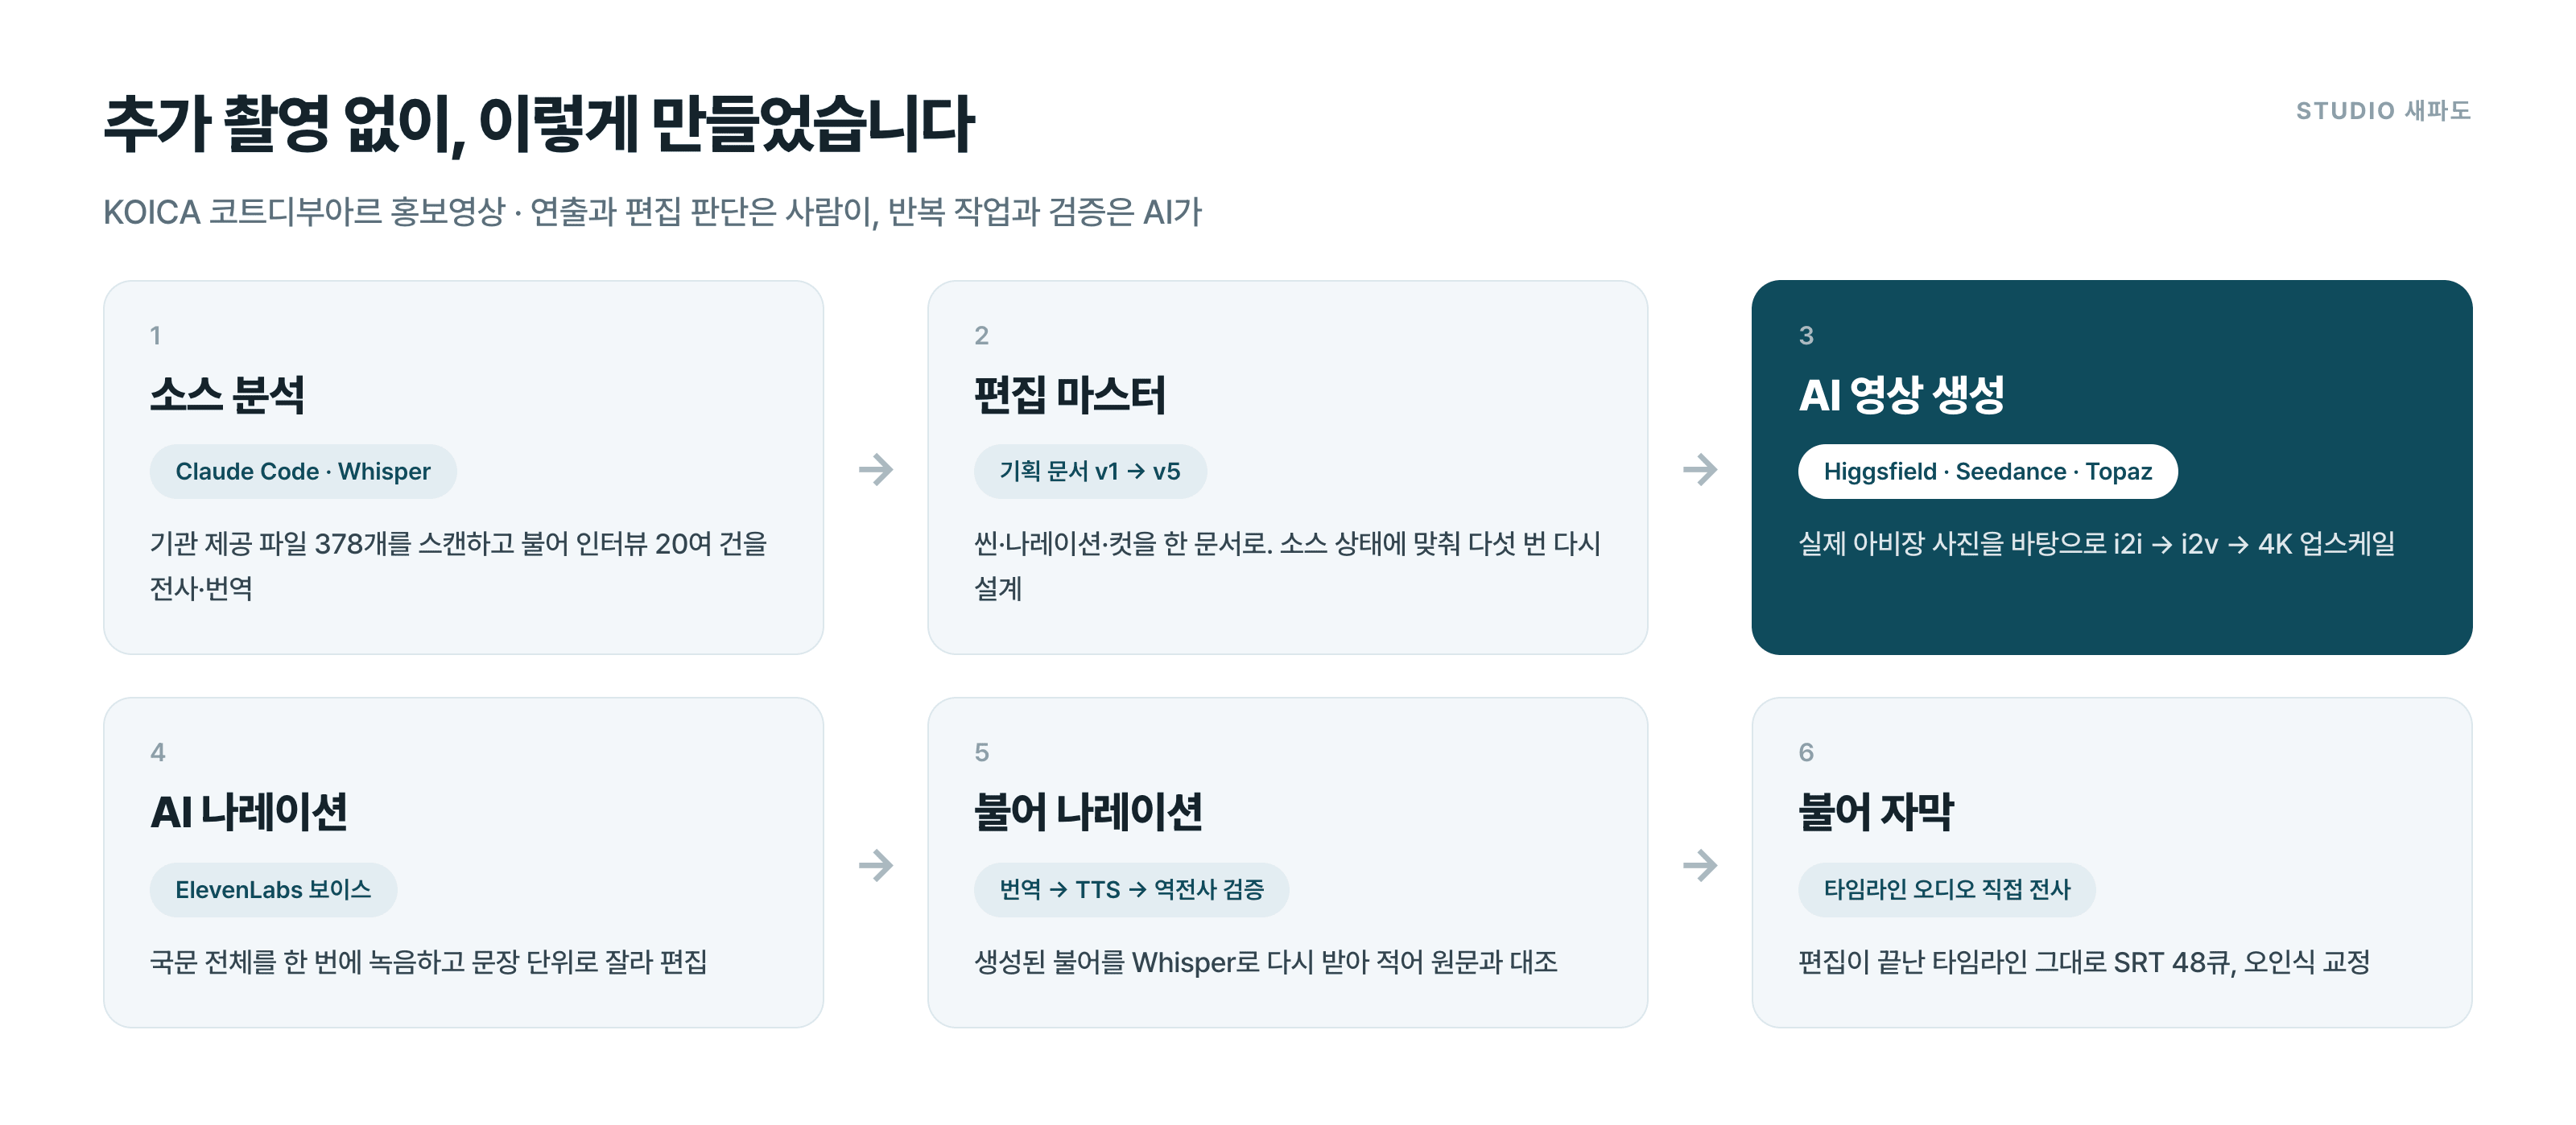
먼저, 받은 파일 378개
8월, 기관에서 컨셉페이퍼와 스토리보드를 받았습니다. 목차는 분명했습니다. 한국이 걸어온 발전의 역사에서 출발해 코트디부아르에 도착하고, 사업별로 달라진 삶을 보여 준 뒤 함께 갈 미래로 닫는 구조. 톤도 구체적이었습니다. 나레이션은 과하지 않게, 음악은 벅차게, KOICA는 '도와주는 주체'가 아니라 '함께 동반하는 존재'로.
문제는 소스였습니다. 사업별 폴더를 받아 보니 영상 371개에 녹음 파일 7개, 모두 378개였습니다. 1920×1080이 대부분이었고, 옛 방송 자료라 화질이 많이 낮은 것도 섞여 있었습니다. 풀스크린으로 쓰기엔 부담스러운 컷이 많았죠. 나중에 UNICEF 사업 영상이 4K로 94개 더 들어오긴 했지만, 영상의 첫인상을 이 소스들로 열 수는 없다고 판단했습니다.
그래서 Claude Code로 파일 전체를 스캔해 인벤토리를 만들고, 인터뷰 20여 건을 전사·번역한 뒤에야 편집 계획을 잡았습니다. 씬, 나레이션, 컷을 한 문서에 정리한 편집 마스터는 v1부터 v5까지, 소스 상태에 맞춰 다섯 차례 다시 짰습니다. 컨셉페이퍼의 목차는 지키되, 세부 연출은 실제로 가진 소스에 맞춰 계속 고쳐야 했으니까요.
스톡 영상 대신 AI 영상 생성을 고른 이유
처음 계획은 스톡 영상이었습니다. 드론 필수 4컷, 일반 필수 5컷, 보강 10~15컷까지 필요한 장면을 추려 Pond5와 셔터스톡을 비교했는데, 아비장 드론 소스가 귀하고 비쌌습니다. 처음 안내드린 범위를 넘겼죠. 구독형 플랜을 여러 계정으로 나눠 쓰는 편법도 있었지만, 약관 위반으로 계정 정지나 라이선스 무효가 될 수 있어 기관에도 권하지 않았습니다.
결국 전경 컷은 AI 영상 생성으로 채우기로 기관과 합의했습니다. 대신 원칙부터 정했습니다.
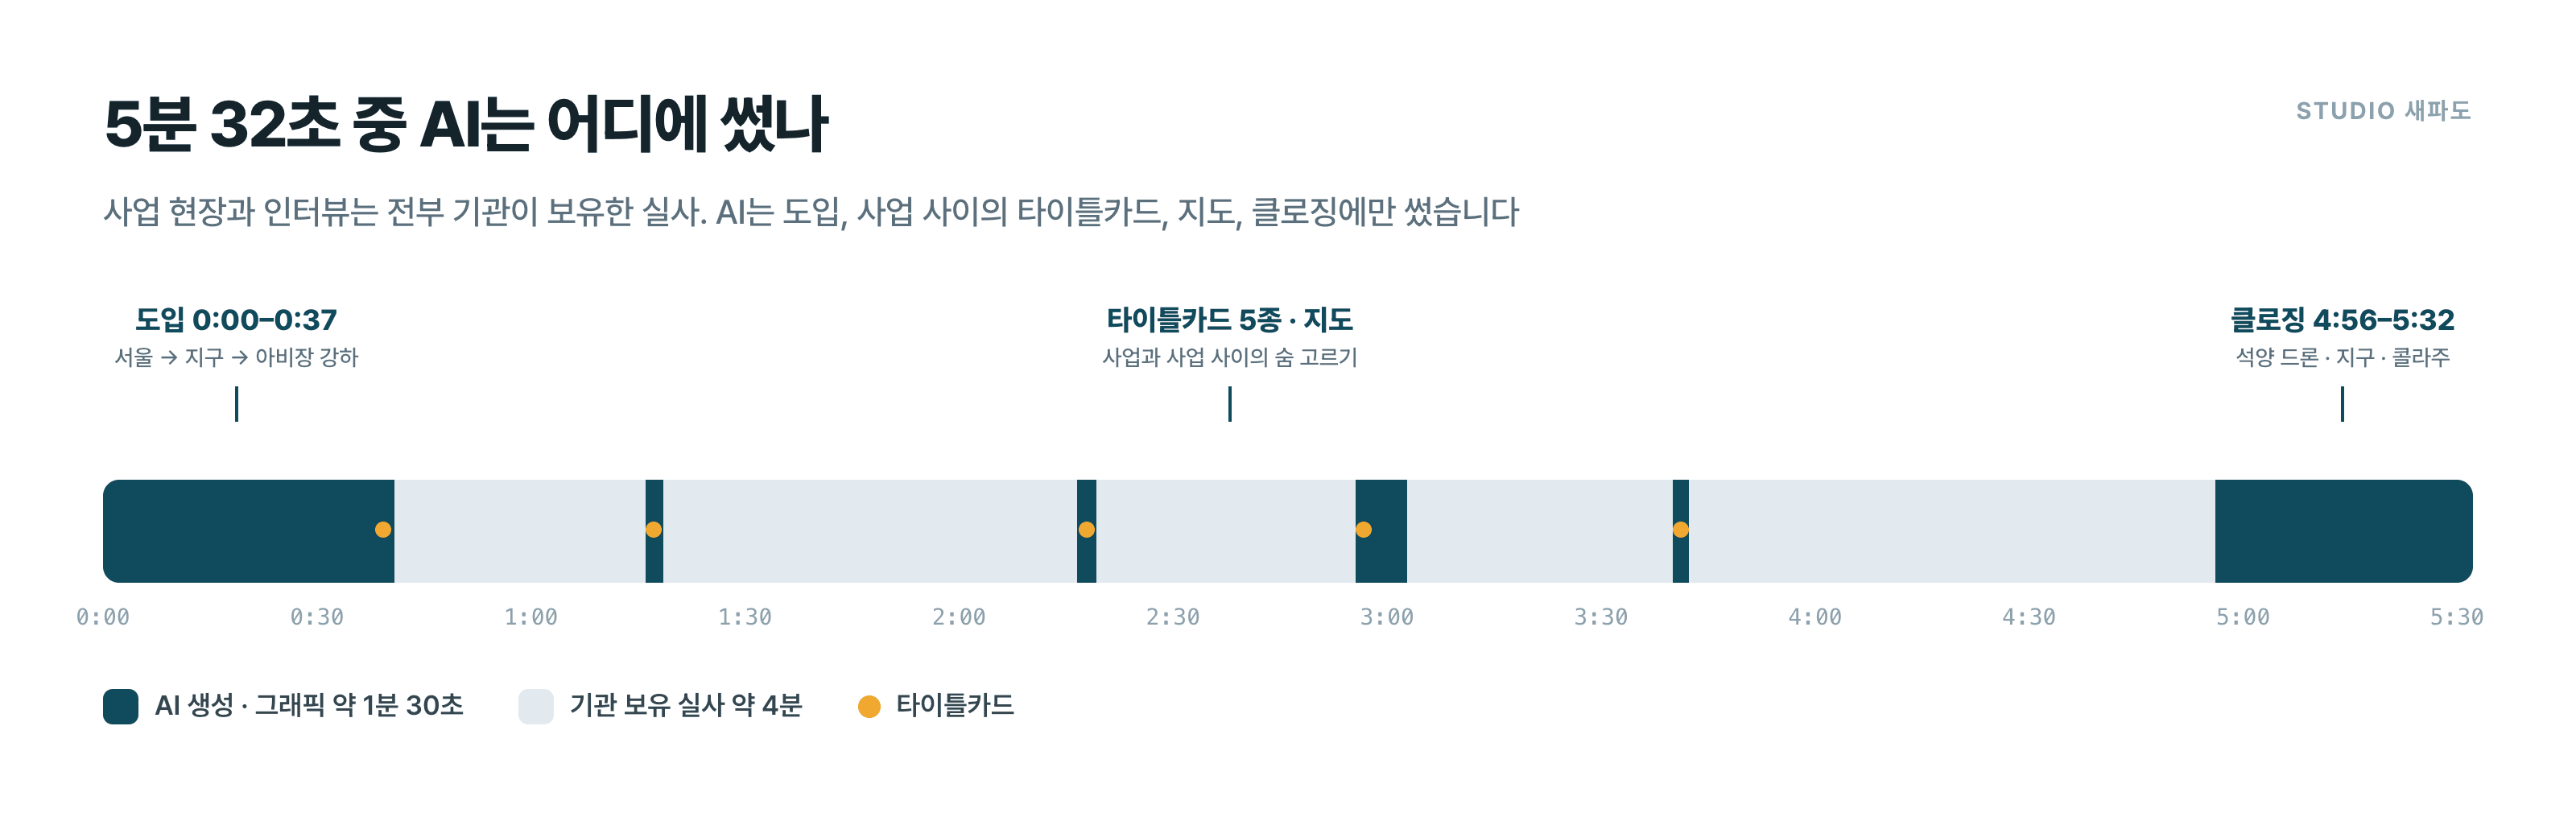
완성본을 놓고 보면 AI와 그래픽이 들어간 건 도입부 37초, 사업과 사업 사이의 타이틀카드 다섯 장, 지도, 마지막 36초 정도입니다. 나머지 4분은 전부 기관이 현장에서 찍어 둔 영상과 인터뷰고요. 첫인상과 마무리는 AI 4K로 단단하게 잡고, 사업 이야기는 실사로 진정성 있게 가는 구간 분리입니다.
아비장처럼 보이는 아비장 만들기
AI 영상 생성에서 처음 부딪힌 건 '다른 나라 같다'는 문제였습니다. 아비장을 글로만 설명해서 만들면 어딘가 그럴듯한 아프리카 도시가 나옵니다. 야자수 같은 관광 기호가 슬쩍 끼어들고요. 그 도시에 사는 사람이 보면 바로 티가 나죠.
그래서 순서를 바꿨습니다. 실제 아비장의 거리와 도심 사진을 먼저 고르고, 이미지 AI(GPT Image)로 건물 형태는 그대로 둔 채 날씨와 빛만 맑은 낮으로 바꿨습니다. 그 스틸을 시작 프레임으로 Higgsfield에서 영상으로 만들고(i2v), 마지막에 Topaz로 4K까지 올렸습니다. 드론 네 컷, 지상 네 컷, 도심의 초고층 빌딩 Tour F를 올려다보는 틸트업 한 컷이 이렇게 나왔습니다.
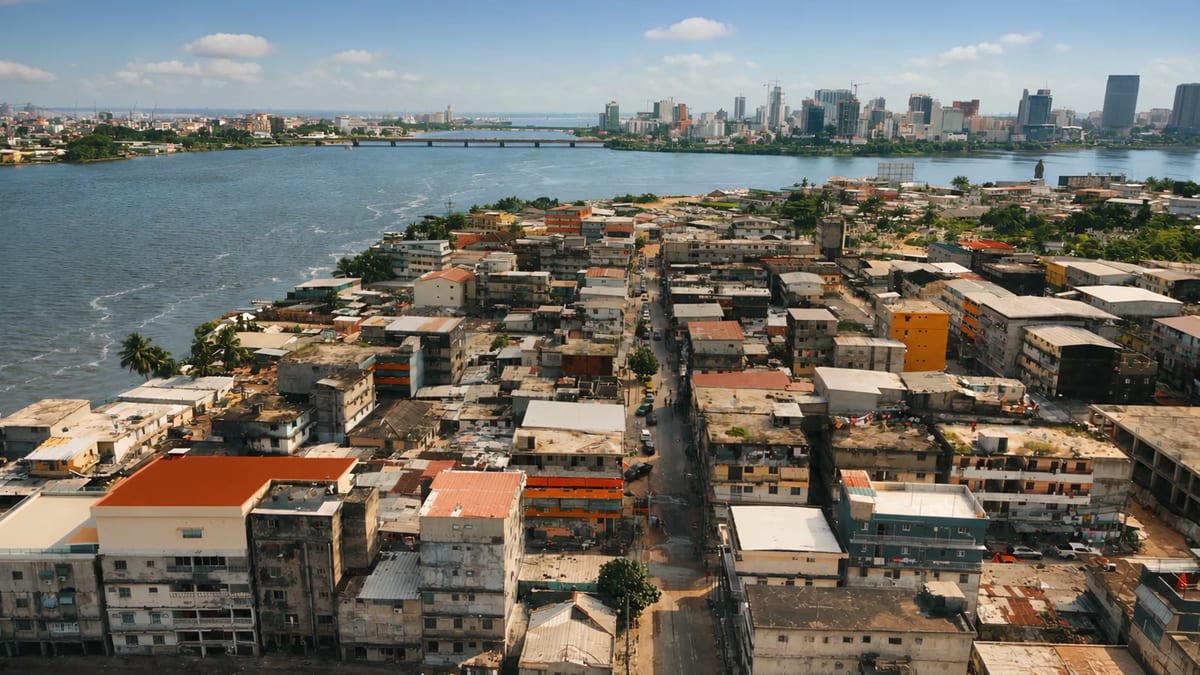
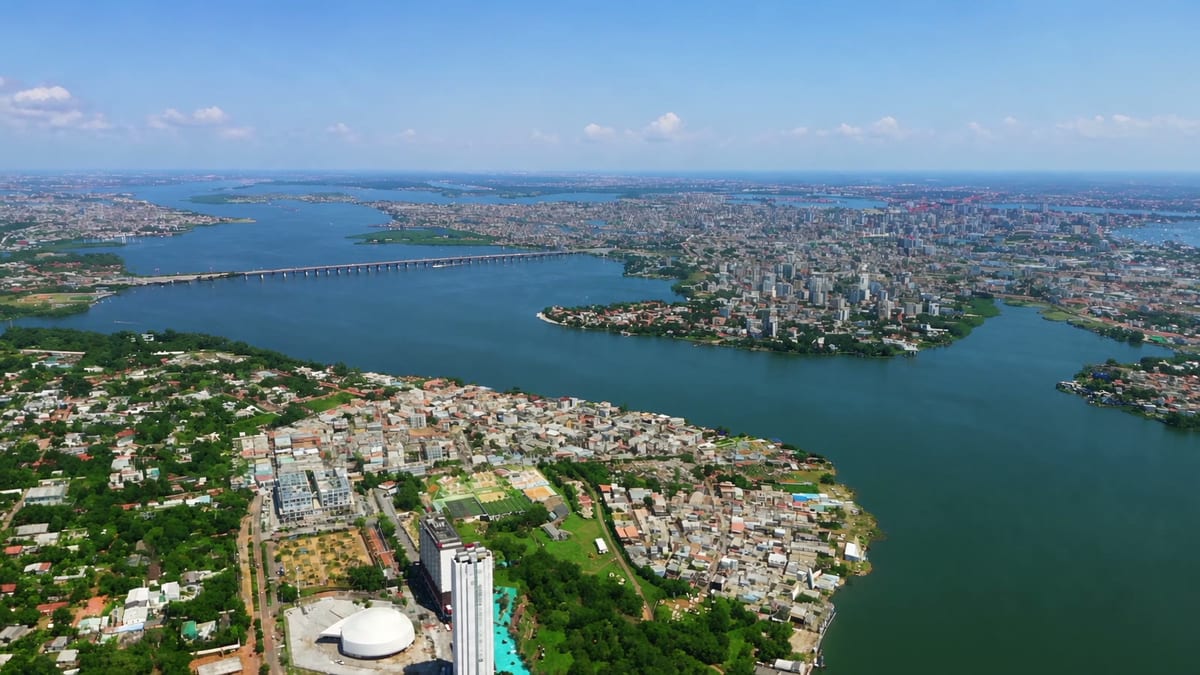
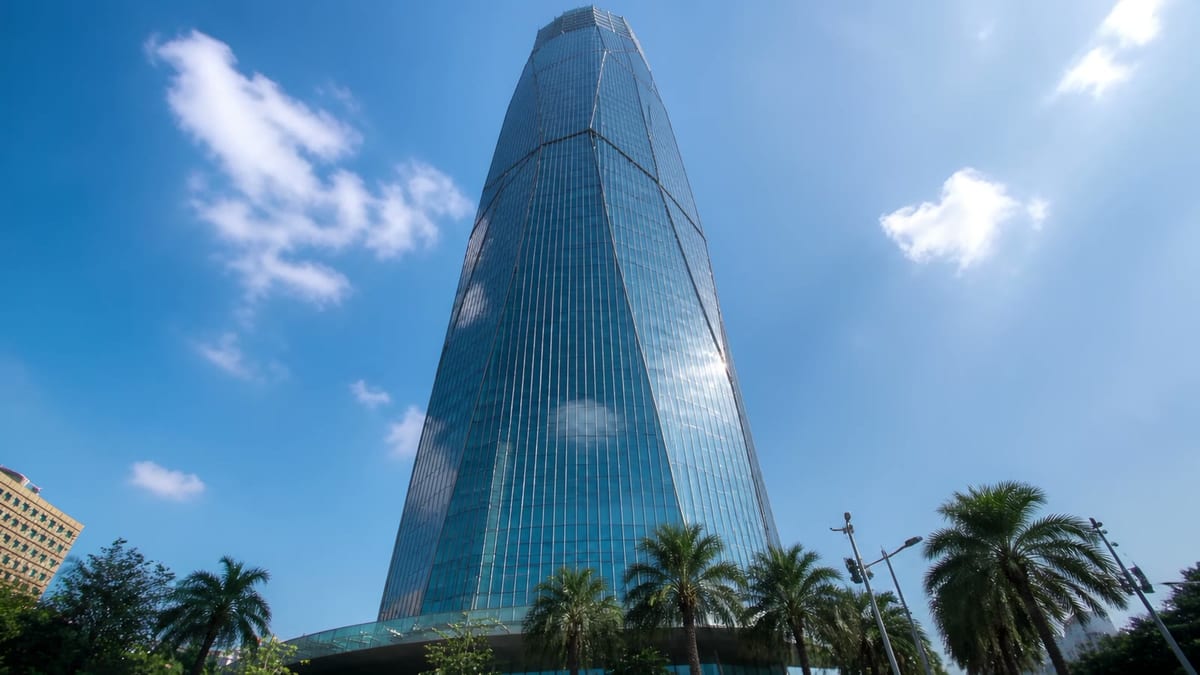
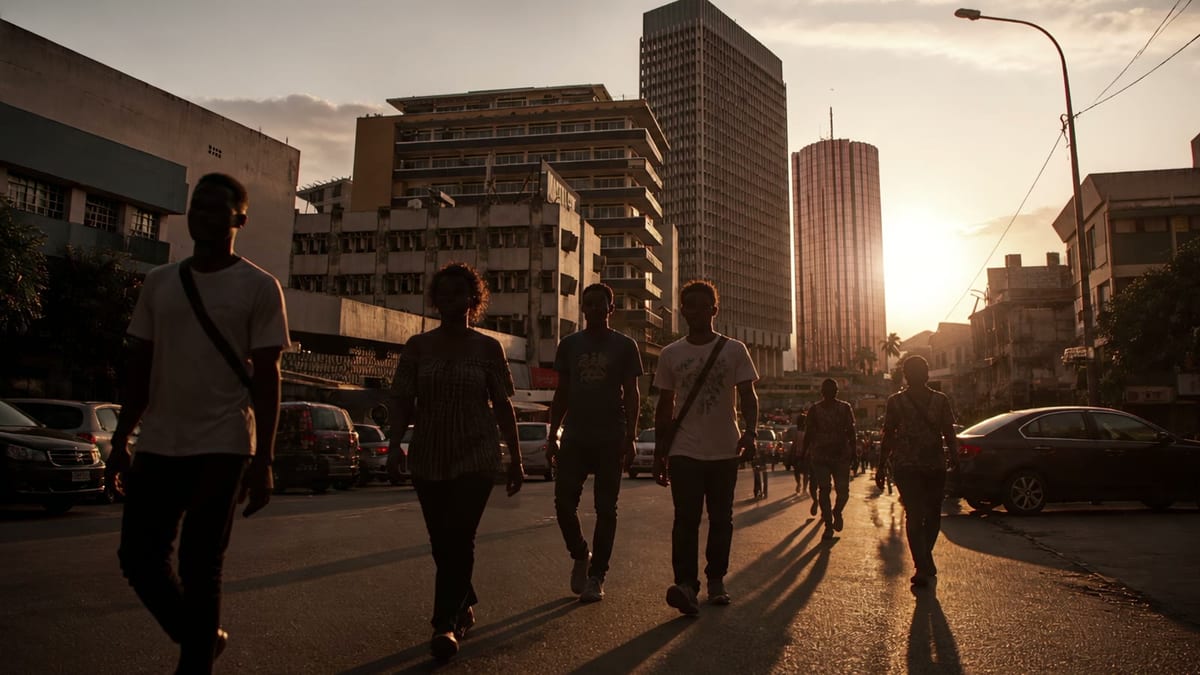
사람이 나오는 AI 컷은 얼굴이 보이지 않는 뒷모습이나 역광 실루엣으로만 썼습니다. AI가 만든 얼굴이 실제 수혜자처럼 보이면 안 되니까요.
맨 위에 올린 오프닝도 쉽지 않았습니다. 국경선과 라벨까지 직접 그린 지구 스틸을 Seedance로 움직였는데, 코트디부아르가 아닌 엉뚱한 곳으로 내려앉곤 했습니다. 결국 목표 지점이 화면 정중앙에 오도록 스틸을 다시 짰습니다. 줌인이 화면 중앙으로 빨려 드는 습성을 거꾸로 이용한 거죠. 480p 미리보기에서 좋던 무빙이 1080p에선 재현되지 않는 일도 있었습니다. 업스케일로 때우면 화면이 우글거려서, 1080p로 여러 번 돌려 가장 좋은 걸 고르는 쪽을 택했습니다. 장면이 중간에 휙 바뀌는 문제는 프롬프트에서 랜드마크 나열을 빼고 '한 장소에서 이어지는 원테이크'로 묶어서 잡았습니다.
사업과 사업 사이, AI 타이틀카드 다섯 장
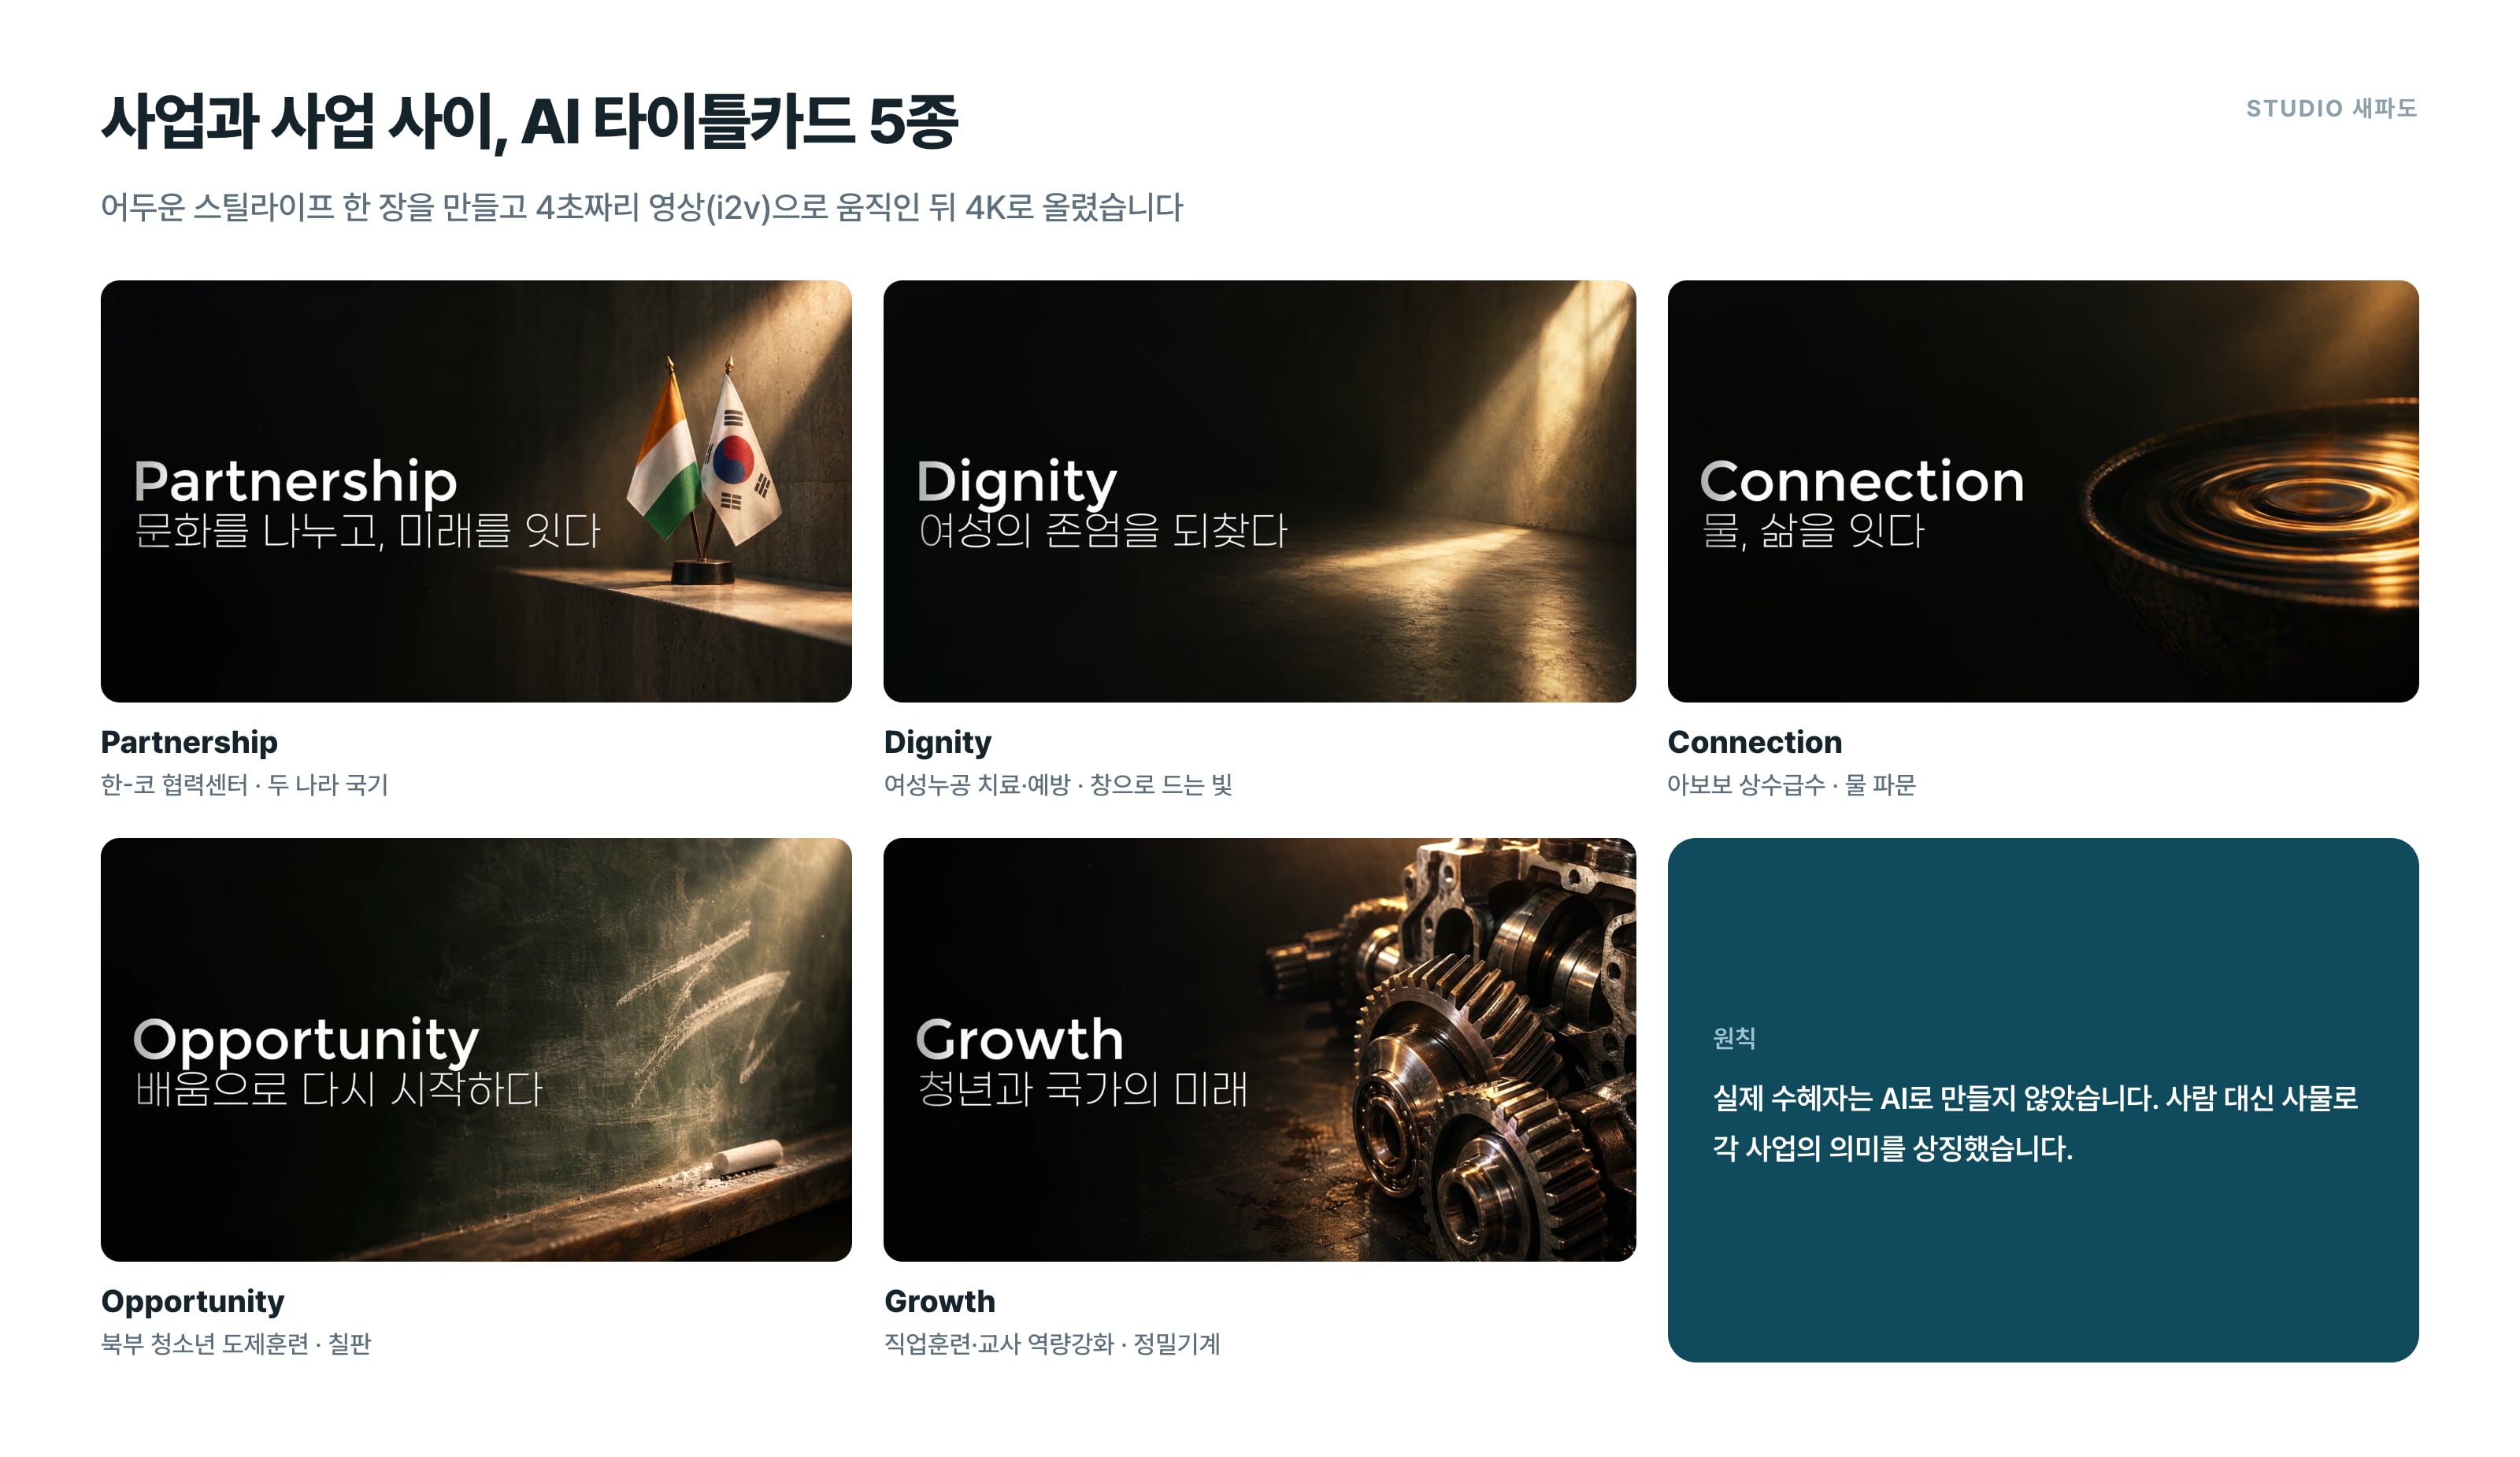
사업 씬 앞에는 4초짜리 타이틀카드를 하나씩 붙였습니다. 어두운 스틸라이프를 한 장씩 만들고 영상으로 움직였습니다. 한-코 협력센터엔 두 나라 국기, 여성누공 치료 사업엔 창으로 드는 빛, 상수급수엔 물의 파문, 청소년 도제훈련엔 칠판, 직업훈련과 교사 역량강화엔 정밀기계. 사람 대신 사물로 각 사업의 의미를 상징했습니다.
화질이 들쭉날쭉한 사업 영상들 사이에서 한 번 숨을 고르게 해 주는 역할도 합니다. 사업이 바뀔 때마다 화면이 같은 룩으로 한 번 정리되니, 5분짜리 영상이 여러 영상을 이어 붙인 것처럼 보이지 않습니다.
AI가 끝까지 못 맞힌 것, 태극기와 지도
공공기관 영상에서 국기와 지도는 틀리면 안 되는 요소입니다. 그런데 AI가 가장 자주 틀린 게 바로 이 둘이었습니다.
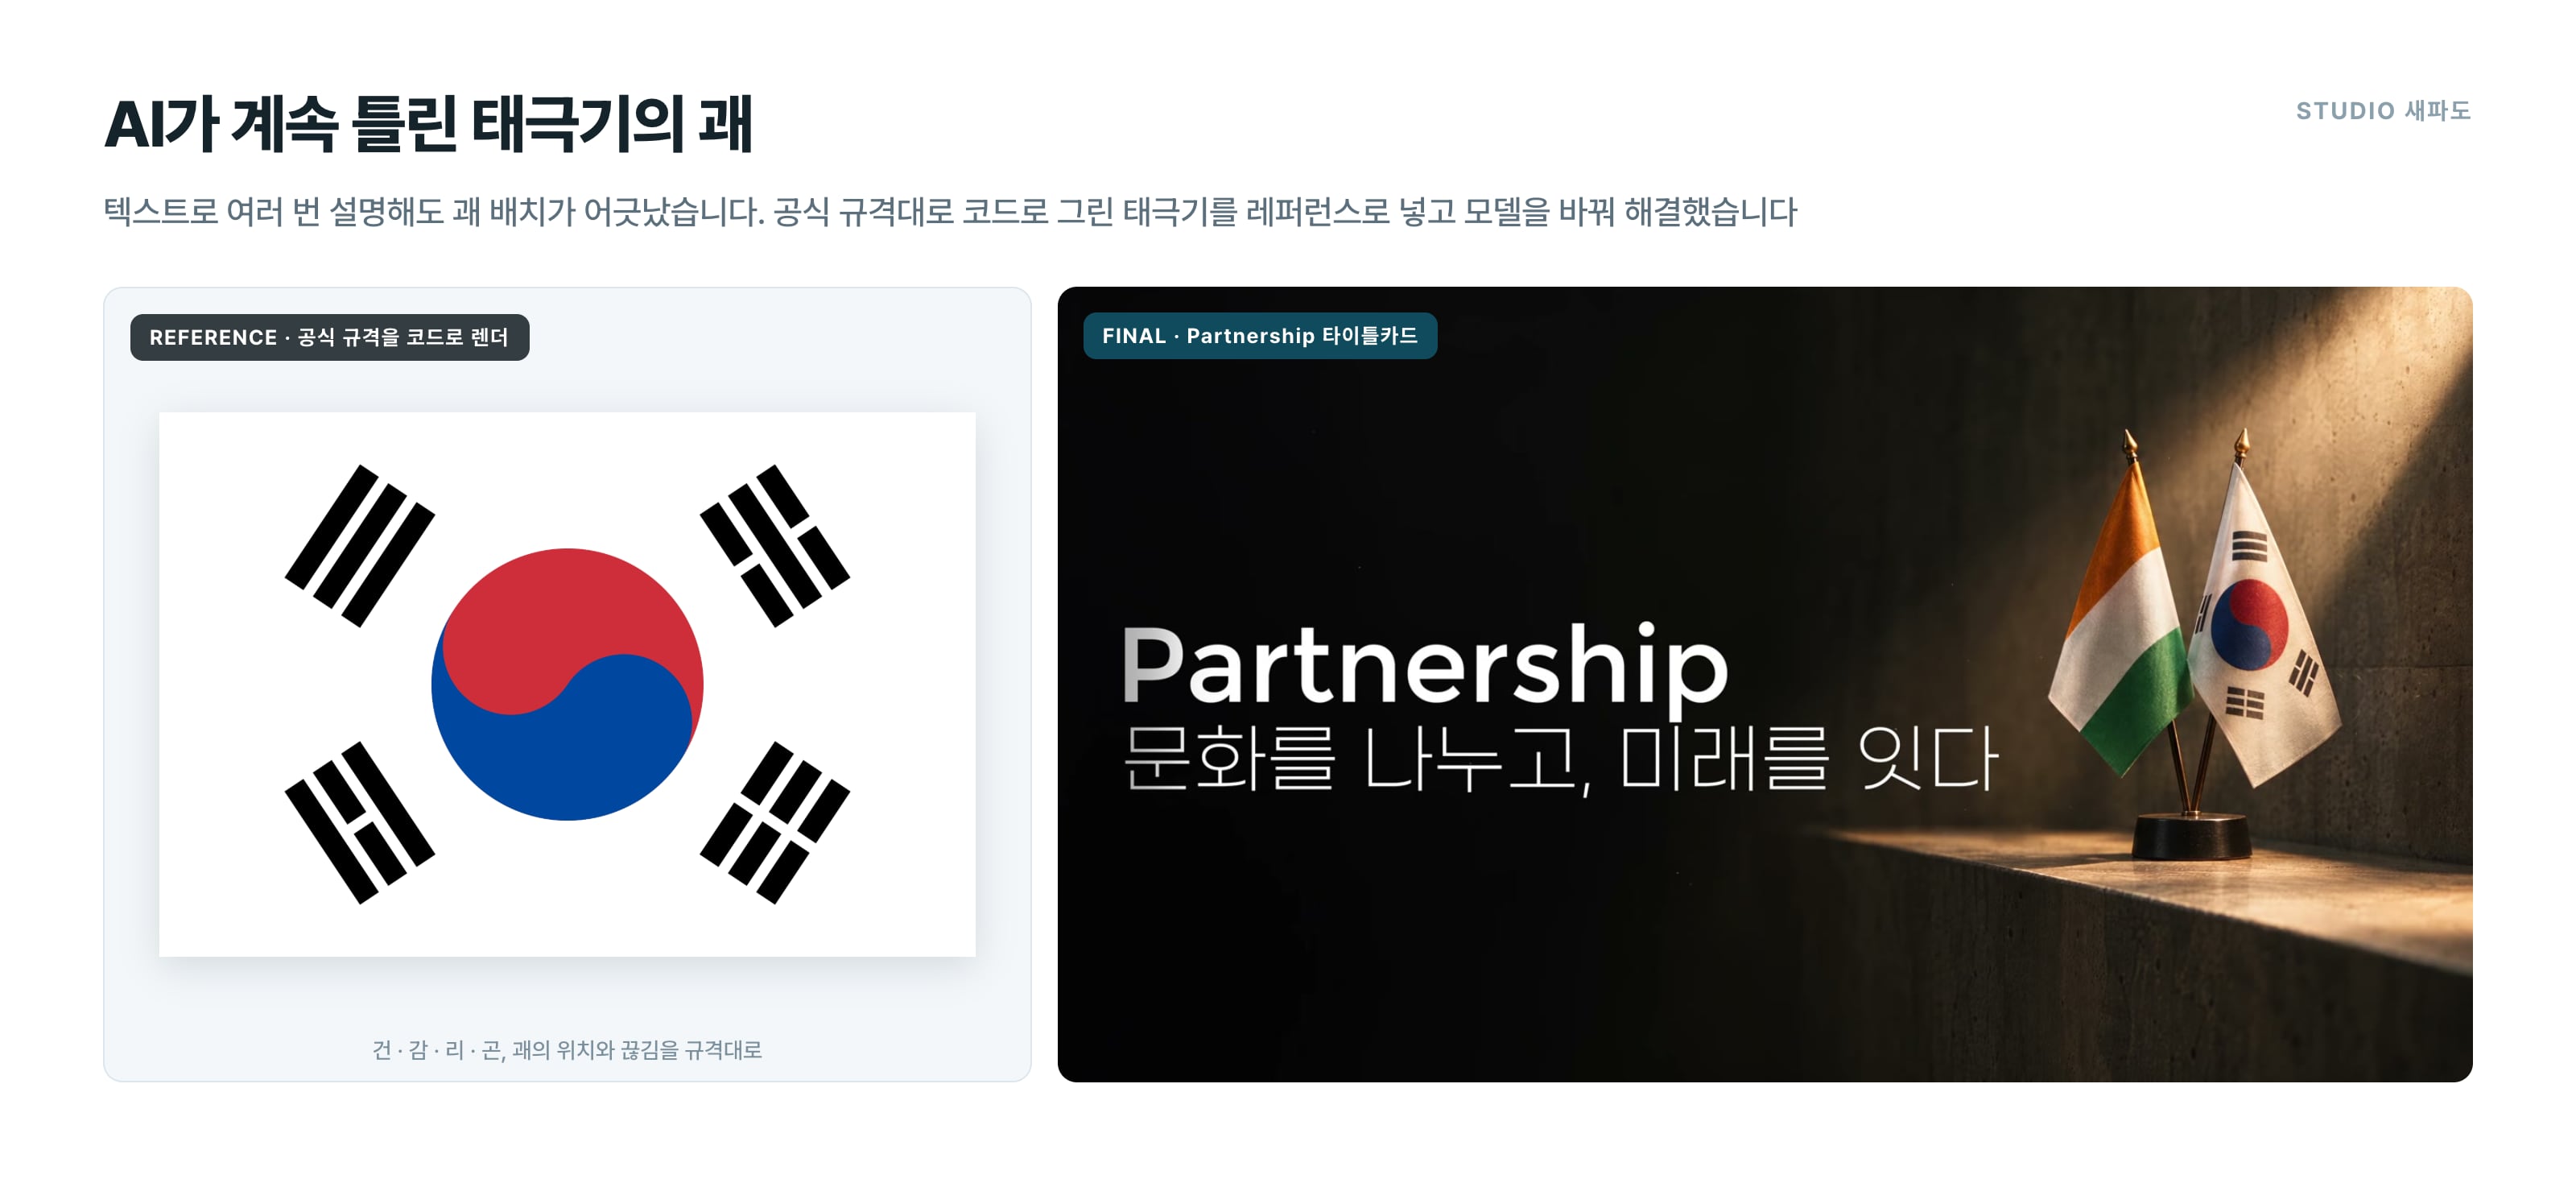
태극기의 괘는 텍스트로 몇 번을 설명해도 배치가 어긋났습니다. 결국 공식 규격대로 태극기를 코드로 그려 레퍼런스 이미지로 넣고, 모델을 Nano Banana로 바꿔서야 맞게 나왔습니다. 오프닝 지구에 적힌 CÔTE D'IVOIRE 라벨에서 글자 하나가 빠져 있던 것도 같은 방법으로 고쳤습니다.
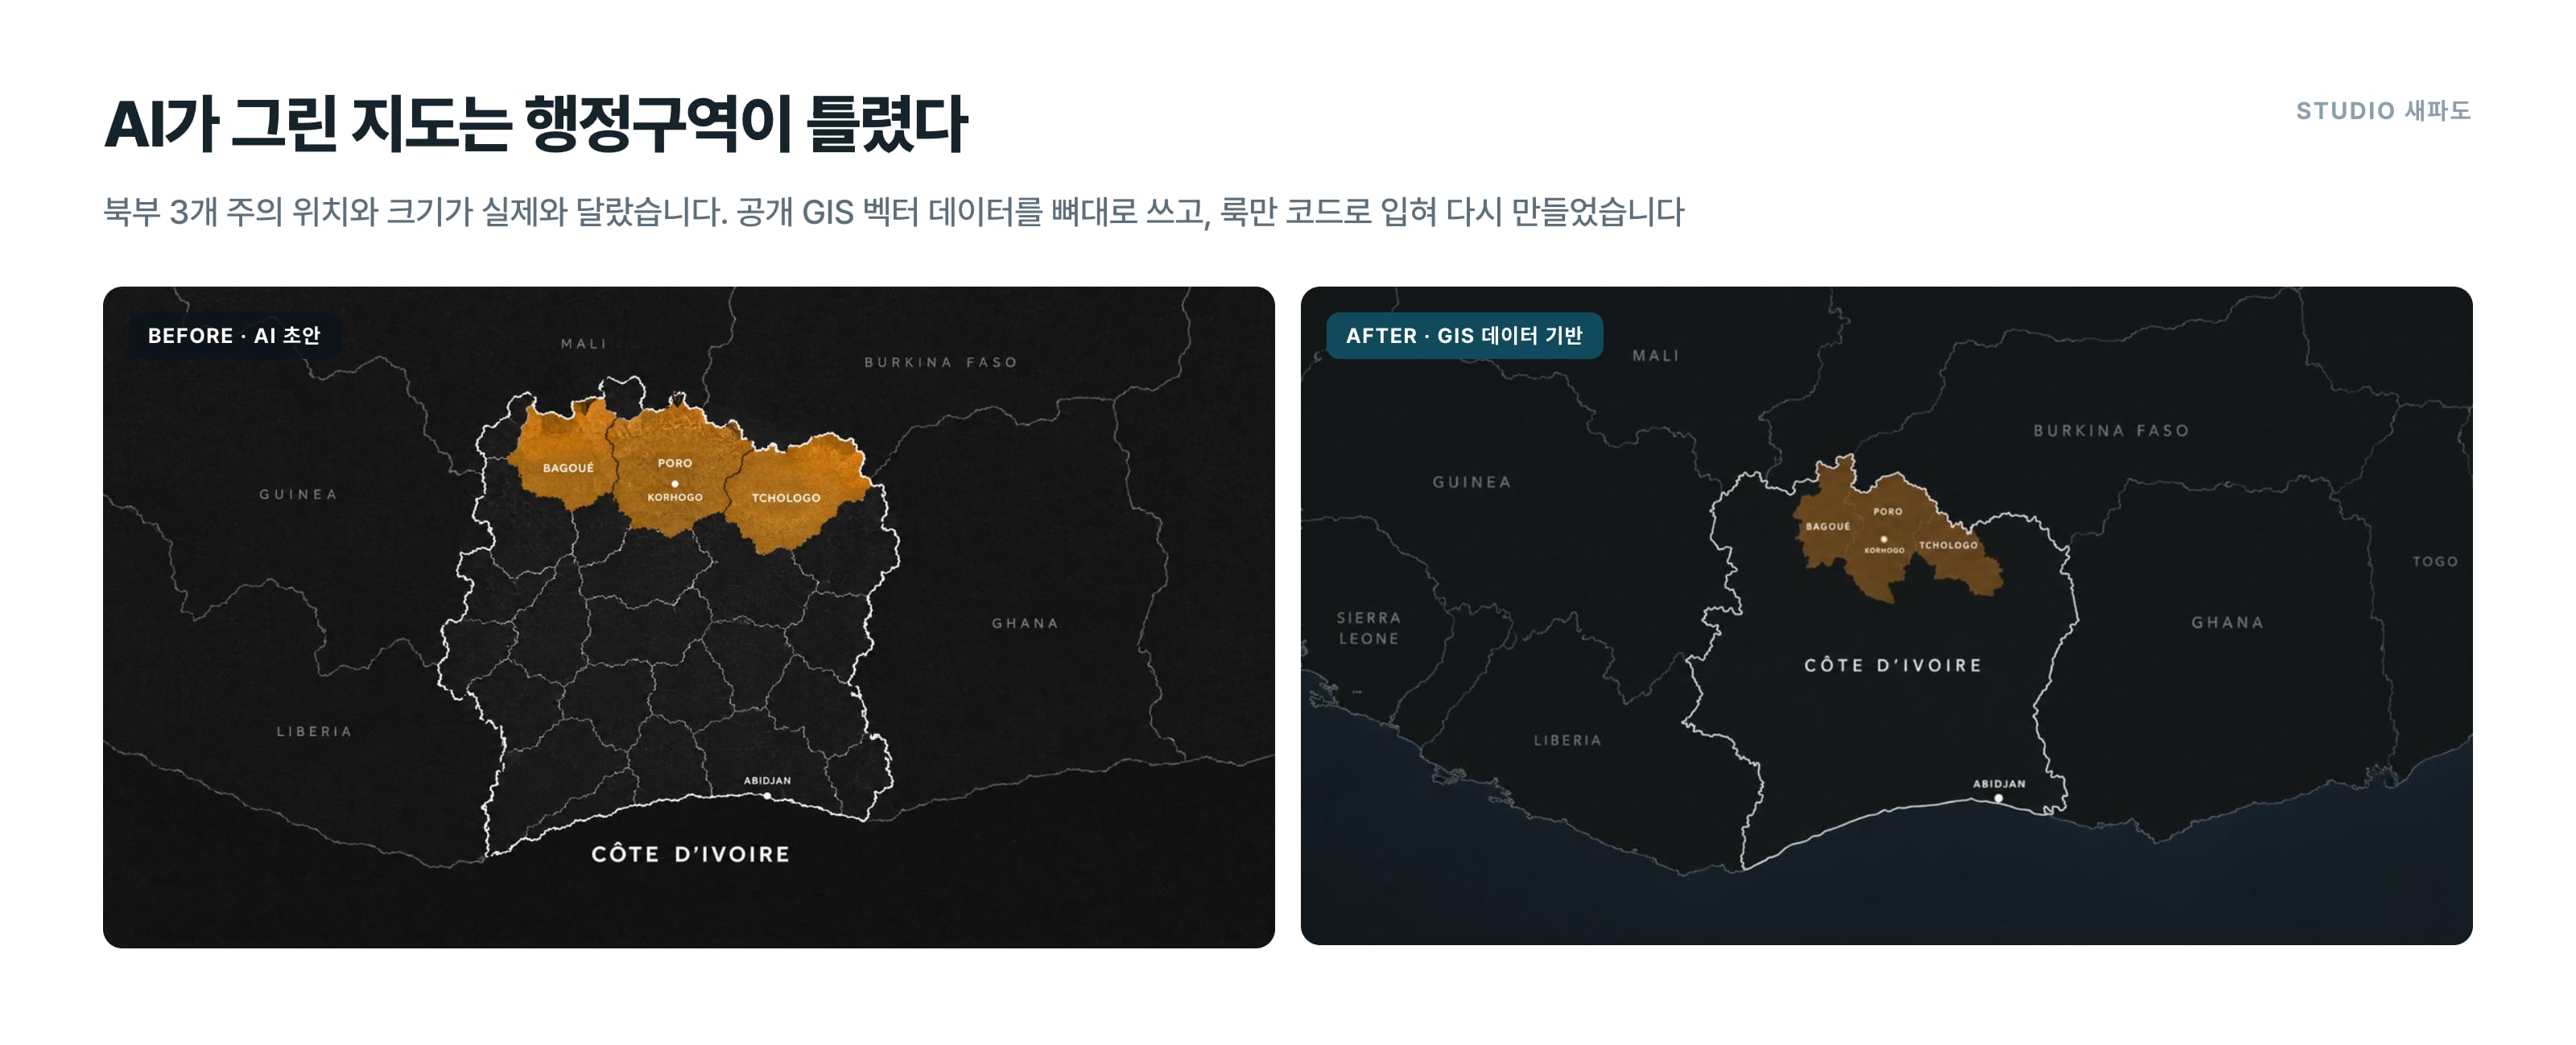
지도는 기관 검수에서 북부 3개 주의 위치와 크기가 실제 행정구역과 다르다는 지적을 받았습니다. AI 초안은 그럴듯해 보였지만 경계가 사실과 달랐던 거죠. 그래서 공개 GIS 벡터 데이터(Natural Earth)를 뼈대로 쓰고, 색과 질감 같은 룩만 코드로 입혀 4K로 다시 만들었습니다.
두 번 다 결론은 같았습니다. 정확해야 하는 건 AI에게 설명하지 말고, 정확한 데이터를 뼈대로 쥐여 줄 것.
불어를 몰라도 불어 인터뷰를 편집하는 법
인터뷰는 모두 불어였습니다. 상수급수 사업 일부는 현지어에 통역까지 섞여 있었고요. 편집자가 알아듣지 못하는 말에서 쓸 멘트를 골라야 하는 상황이었습니다. 이걸 푼 게 음성 인식 전사, Whisper였습니다.
처음에는 빠른 모델(large-v3-turbo)로 인터뷰 20여 건을 전사·번역해 편집 마스터를 짰습니다. 그런데 9월 중순 편집 도중, 발췌해 둔 구간의 타임코드가 실제 발화와 어긋난다는 걸 발견했습니다. 그래서 인터뷰 21개 파일을 처음부터 다시 전사했습니다. 이번엔 정확도가 높은 large-v3에 언어를 불어로 고정하고, 목소리가 있는 구간만 골라 듣게(VAD) 하고, 앞 문장 맥락을 참조하지 않게 설정해서요.
결과는 꽤 충격적이었습니다. 편집 마스터에 발췌해 둔 22개 구간 중 그대로 쓸 수 있는 건 6개뿐이었습니다. 질문자와 스태프 목소리가 섞인 구간이 많았고, 한 문장처럼 적혀 있던 말이 실제로는 그런 문장으로 존재하지 않은 경우도 있었습니다. 통역이 주민의 말을 요약하면서 원래 없던 문장이 끼어든 곳도 있었습니다. 자막은 화자가 직접 한 말에만 달기로 하고, 해당 구간은 전부 걸러냈습니다.
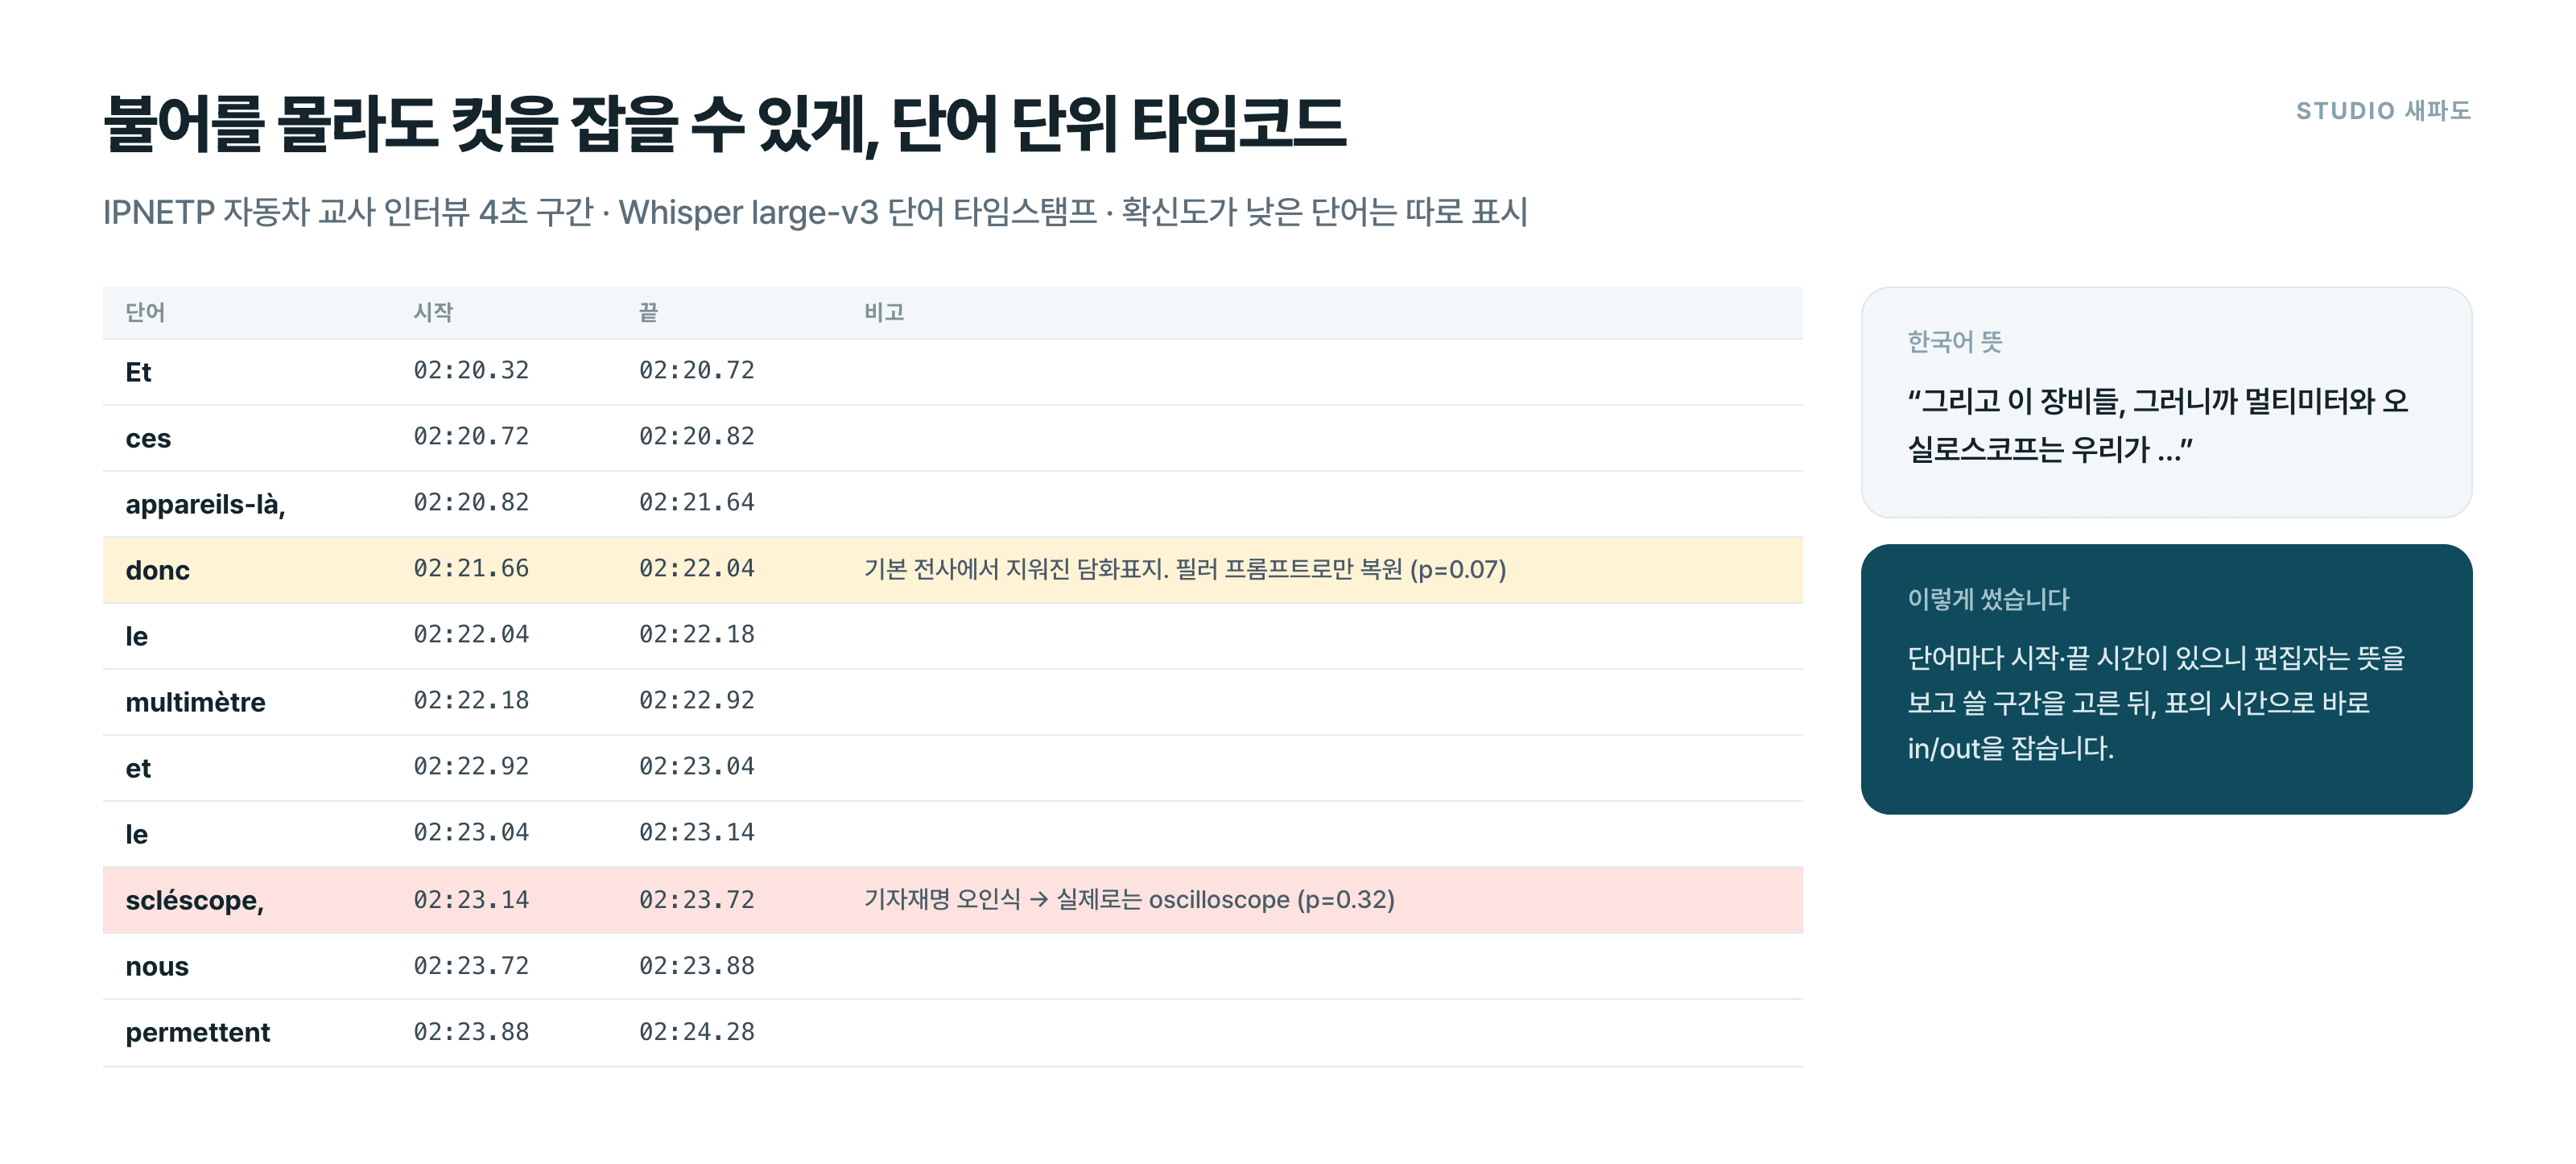
편집자를 위해서는 단어 단위로 표를 만들었습니다. 단어마다 시작·끝 시간이 있고, 한국어 뜻과 불어 발음의 한글 표기, 쓸 구간 형광 표시가 붙어 있습니다. 뜻을 보고 구간을 고르면 표의 시간으로 바로 in/out을 잡을 수 있죠. 확신도가 낮은 단어는 따로 표시해 한 번 더 확인했습니다. 위 표에서 'scléscope'는 사실 오실로스코프(oscilloscope)였고, 'donc' 같은 머뭇거림은 기본 전사에서 아예 지워져 있었습니다. 컷을 자르는 사람에겐 이 머뭇거림 하나가 편집점이 되기도 합니다.
AI 나레이션 - 한국어는 한 번에, 불어는 역전사로 검증
나레이션은 국문과 불문 모두 AI 성우로 만들었습니다.
한국어는 엔진 비교부터 했습니다. 처음 써 본 프리셋은 한국어 억양이 어색해 탈락했고, MiniMax·ElevenLabs·Seed Speech를 비교한 뒤 MiniMax에서 남성 보이스 10종을 추렸습니다. 그런데 원고 전체를 일괄 녹음해 보니 뉘앙스가 미묘하게 어긋나, 최종은 ElevenLabs 엔진의 남성 보이스로 확정했습니다. 샘플 한두 문장만 듣고 고르면 안 되고, 실제 원고로 끝까지 들어 봐야 차이가 보입니다.
- 1문장을 하나씩 따로 만들지 않는다. 원고 전체를 한 번에 녹음하고 편집에서 문장 단위로 자른다.
- 2고칠 문장은 앞뒤 문장과 함께 다시 녹음하고 가운데만 잘라 쓴다. 한 문장만 녹음하면 억양이 튄다.
- 3약어는 한글로 입력한다. KOICA는 '코이카', UNICEF는 '유니세프'로 넣어야 알파벳으로 읽히지 않는다.
불어 버전은 편집이 거의 끝난 9월 하순에 요청이 왔습니다. 국문 나레이션을 불어로 옮기면서, 불어가 한국어보다 길어지는 걸 감안해 문장을 압축했습니다. 기관명도 불어권 관행대로 la KOICA, l'UNICEF처럼 썼고요.
문제는 발음 검수였습니다. 저희가 불어를 못 하니 AI가 제대로 읽었는지 판단할 수가 없었습니다. 그래서 생성된 불어 음성을 Whisper로 다시 받아 적어 원문과 단어 단위로 대조했습니다. 첫 검수에서 단어 오류율(WER)은 2.4%였고, 그중에는 원고 버전 차이에서 생긴 오탐도 섞여 있었습니다. 발음이 불안정하게 나온 합성어는 발음하기 안전한 표현(Corée–Côte d'Ivoire)으로 바꿔 다시 녹음했습니다.
불어 자막은 한국어 자막을 불어로 다시 번역하지 않았습니다. 편집이 끝난 타임라인에서 인터뷰 오디오만 살려 내보내 전사하고, 타임라인 타임코드 그대로 48개 자막 큐를 만들었습니다. 음성 인식이 잘못 알아들은 13곳은 앞서 재전사한 원문과 대조해 고쳤습니다. 사업 설명 카드는 기관 요청에 따라 영문으로 옮겼습니다.
기관 피드백 세 번, 모두 반영
기획안 승인 뒤 기관 피드백은 세 차례 왔습니다. 일부 표현 삭제와 불어 버전 요청, 지도의 행정구역, 그리고 불어 자막 한 문장과 사업 카드 문구, 나레이션 두 곳까지. 전부 반영했고, 태극기와 라벨 철자도 이 과정에서 함께 바로잡았습니다.
그중 불어 자막 수정은 원인까지 짚어 볼 만했습니다. 수혜자가 학위를 받았다고 말하는 대목에서, 음성 인식이 짧은 표현 하나를 비슷한 소리의 다른 말로 받아 적은 게 발단이었습니다. 자동 전사는 빠르지만, 최종 자막은 결국 사람이 한 번 더 봐야 합니다.
결과 - 국문판과 불문판, 5분 32초
최종 결과물은 4K 16:9, 5분 32초입니다. 국문판에는 국문 AI 나레이션과 인터뷰 원어(불어), 한국어 자막, 국문 사업 카드가 들어갔고, 불문판에는 같은 보이스의 불어 나레이션과 불어 자막, 영문 사업 카드가 들어갔습니다.
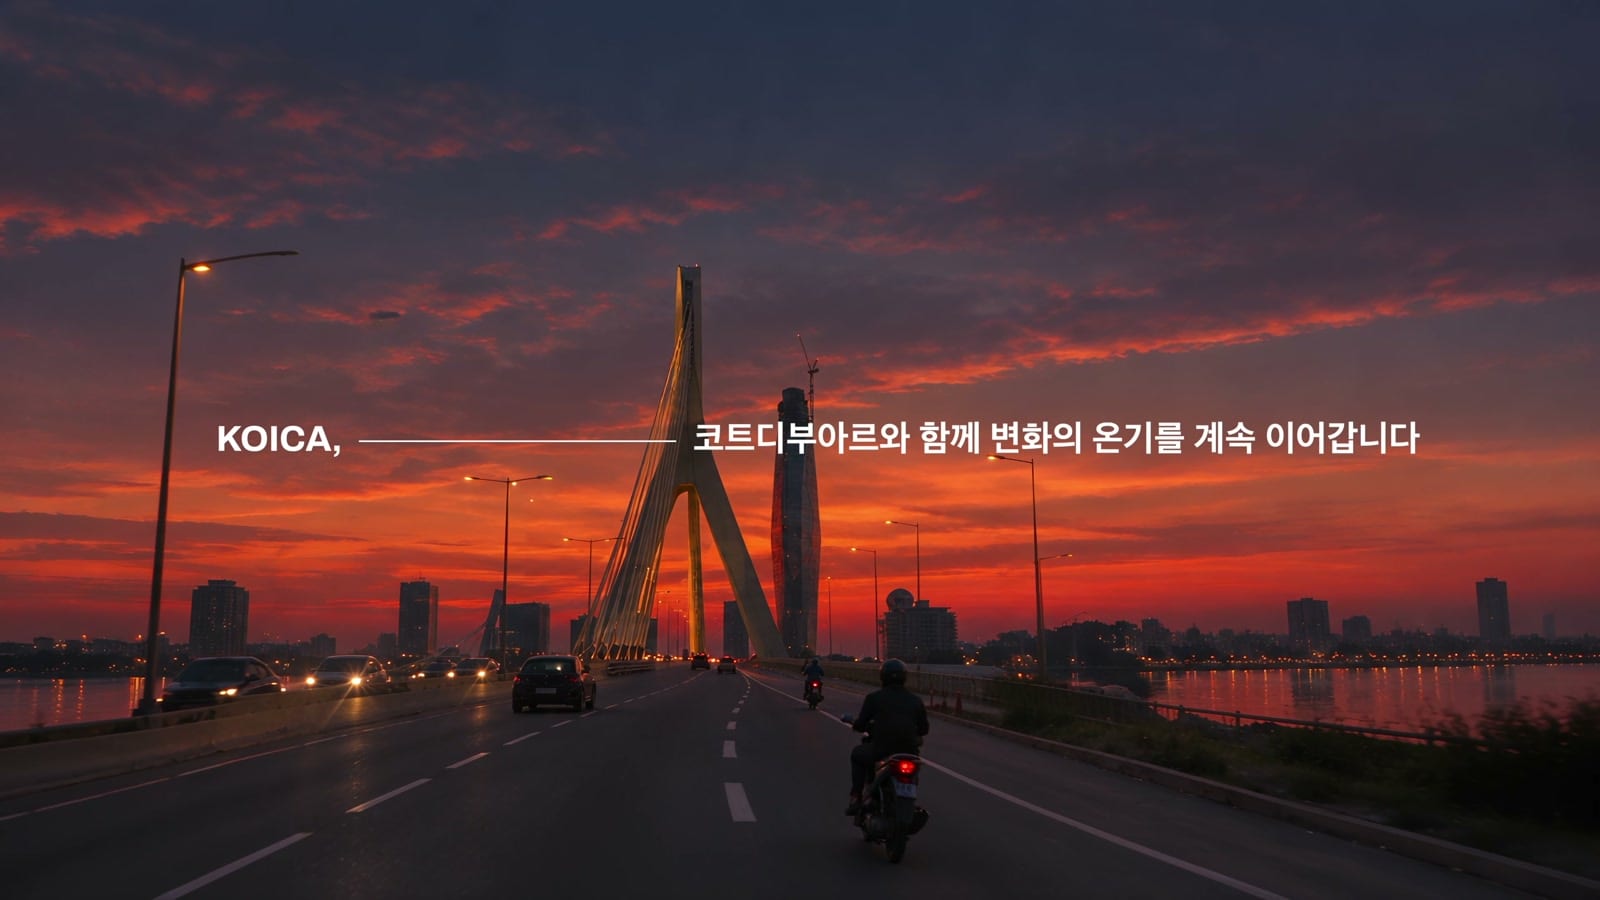
영상은 'KOICA, 코트디부아르와 함께 변화의 온기를 계속 이어갑니다'라는 문장으로 닫힙니다. 새로 찍은 컷 하나 없이, 기관이 쌓아 온 현장 기록에 AI로 도시의 풍경과 목소리를 입혀 완성한 영상입니다.
이번 작업으로 정리한 AI 영상제작 기준
AI 덕분에 추가 촬영 없이 해외 사업을 담은 공공기관 홍보영상을 만들 수 있었습니다. 다만 버튼 하나로 끝나는 일은 아니었습니다. 어디에 AI를 쓰고 어디에 쓰지 않을지, AI가 만든 걸 무엇으로 검증할지 정하는 게 작업의 절반이었습니다.
- 1실제 사람은 AI로 만들지 않는다. AI 컷은 풍경·뒷모습·사물로.
- 2국기와 지도처럼 정확해야 하는 건 공식 규격과 데이터를 뼈대로 준다.
- 3알아듣지 못하는 언어는 기계로 다시 검증한다. 전사하고, 다시 받아 적고, 대조한다.
- 4소스의 한계는 구간 분리로 푼다. 첫인상과 마무리는 AI 4K로, 사업 이야기는 실사로.
해외 사업이나 공공기관 홍보영상, 다국어 버전 제작을 준비하고 계시다면 제작 문의로 연락 주세요. 가지고 계신 소스부터 같이 보고, 어디까지 실사로 가고 어디를 AI로 채울지 먼저 나눠 드립니다. 공공기관 영상이 민간 영상과 무엇이 다른지는 공공기관 홍보영상 제작 가이드에, AI 영상을 직접 만들 때와 업체에 맡길 때의 차이는 AI로 영상 만들기, 어디까지 직접 할까에 정리해 두었습니다. AI 후반작업으로 촬영의 한계를 넘은 다른 사례는 한해·문세윤 '비행기' 뮤직비디오 제작기와 자이르네 브랜드 필름 제작기에서 보실 수 있습니다.
자주 묻는 질문
- Q. 촬영 없이 기관이 가진 영상만으로 홍보영상을 만들 수 있나요?
- 소스가 사업 현장을 충분히 담고 있으면 가능합니다. 이번 KOICA 코트디부아르 홍보영상은 추가 촬영 없이 만들었습니다. 사업 현장과 인터뷰는 기관이 가진 실사를 쓰고, 화질이 부족하거나 아예 없는 도시 풍경·도입·전환·클로징은 AI 영상 생성으로 채웠습니다. 먼저 받은 파일을 전부 분석해 어떤 장면을 실사로, 어떤 장면을 AI로 채울지 구간부터 나누는 것이 핵심입니다.
- Q. 공공기관 홍보영상에 AI 생성 영상을 써도 되나요?
- 쓰되 원칙이 필요합니다. 저희는 실제 수혜자나 현장 인물을 AI로 만들지 않았고, AI 컷은 얼굴이 드러나지 않는 풍경·뒷모습·사물 위주로만 썼습니다. 국기와 지도처럼 틀리면 안 되는 요소는 AI에 설명으로 맡기지 않고 공식 규격과 GIS 데이터를 뼈대로 다시 만들었습니다. AI 사용 범위는 기관과 먼저 합의하고 진행했습니다.
- Q. AI 나레이션(AI 성우)은 어떻게 고르고 녹음하나요?
- 여러 엔진의 한국어 억양을 비교해 고릅니다. 이번에는 MiniMax·ElevenLabs·Seed Speech를 비교한 뒤 ElevenLabs로 확정했습니다. 문장을 하나씩 따로 만들면 톤과 속도가 달라지기 때문에 원고 전체를 한 번에 녹음하고 편집에서 문장 단위로 자릅니다. KOICA를 '코이카'처럼 약어는 한글로 입력해야 알파벳으로 읽히지 않습니다.
- Q. 불어·영어 같은 외국어 버전은 제작사가 그 언어를 몰라도 만들 수 있나요?
- 검증 절차가 있으면 가능합니다. 불어 나레이션은 AI로 만든 뒤 Whisper로 다시 받아 적어 원문과 단어 단위로 대조했고, 발음이 흔들리는 표현은 바꿔서 다시 녹음했습니다. 불어 자막은 편집이 끝난 타임라인 오디오를 직접 전사해 타임코드를 그대로 맞췄습니다. 최종 표현은 기관 검수로 한 번 더 확인했습니다.
- Q. 외국어 인터뷰 영상은 어떻게 편집하나요?
- 음성 인식으로 단어 단위 타임코드를 뽑습니다. 이번에는 Whisper large-v3로 인터뷰를 전사해 단어마다 시작·끝 시간을 표로 만들고, 쓸 구간을 한국어 뜻과 함께 표시했습니다. 편집자는 뜻을 보고 구간을 고른 뒤 그 시간으로 바로 컷을 잡습니다. 질문자 음성이 섞인 구간이나 통역이 원래 발화를 바꾼 구간은 자막 근거로 쓰지 않았습니다.


